Problemas de indexación: las causas más comunes
Problemas de indexación: las causas más habituales

⚡ Idea clave
Los problemas de indexación hacen que páginas web valiosas sigan siendo invisibles en los buscadores, lo que se traduce directamente en una pérdida de tráfico orgánico y de conversiones. Cuando Google no puede indexar tu contenido, tu web queda oculta para tu público objetivo, sea cual sea su calidad. Detectar a tiempo barreras técnicas como una configuración errónea del robots.txt o unas etiquetas canonical incorrectas es esencial para tu visibilidad online. Si revisas de forma sistemática la arquitectura del sitio, podrás eliminar estos bloqueos y reforzar la autoridad de tu dominio.
Por qué es importante
Los problemas de indexación persistentes socavan toda tu estrategia SEO y exigen un análisis técnico a fondo.
- Etiquetas noindex en el código fuente.
- La optimización del sitemap XML.
- Errores del servidor y contenido duplicado.
Abordar los problemas de indexación de forma proactiva evita que pierdas rentabilidad por culpa de la invisibilidad técnica.
¿Qué son los problemas de indexación y por qué perjudican tu SEO?
Cuando hablamos de la visibilidad de una web, la base siempre es estar presente en la base de datos de buscadores como Google. Los problemas de indexación aparecen cuando a los buscadores les cuesta encontrar, rastrear o almacenar páginas en su índice. Este proceso es crucial, porque una página que no está indexada sencillamente no existe para el usuario medio. Es como un libro que se ha escrito pero que nunca se ha incluido en el catálogo de la biblioteca: nadie podrá tomarlo prestado ni leerlo. Para quien tiene una web, esto supone una pérdida directa de tráfico potencial y de visibilidad.
Sin una indexación correcta, tus textos y productos más valiosos siguen siendo invisibles para tu público objetivo, por muy bien escrito que esté el contenido.
El impacto de las barreras técnicas en tu posicionamiento
Las consecuencias de estos fallos técnicos van más allá de que falte una página concreta. Cuando Google se topa una y otra vez con ajustes de indexación erróneos, puede resentirse la confianza general en la integridad técnica de todo tu dominio. Los buscadores dedican un presupuesto limitado a rastrear tu sitio. Si ese presupuesto se desperdicia en callejones sin salida o en recursos bloqueados, las páginas realmente importantes a menudo quedan sin descubrir. Esto genera un círculo vicioso en el que tu autoridad se estanca y tus competidores, que sí tienen la parte técnica en orden, te adelantan sin esfuerzo en los resultados de búsqueda.
Saber detectar a tiempo cómo solucionar los problemas de indexación para ganar visibilidad es esencial en cualquier estrategia de crecimiento digital. A menudo las causas están en archivos robots.txt mal configurados, en etiquetas noindex que se quedaron olvidadas tras una fase de pruebas o en estructuras de URL complejas que confunden a los rastreadores. En la práctica vemos que muchas empresas bloquean su propio éxito sin saberlo al levantar estos muros invisibles ante los buscadores.
Una web sana empieza por una estructura transparente que invita a explorarla, tanto a los visitantes humanos como a los algoritmos.
Por qué Google a veces ignora tus páginas
ℹ️ Motivos importantes
Los problemas de indexación pueden surgir por muchos motivos, desde el contenido duplicado hasta unos tiempos de carga lentos que hacen que el rastreador abandone. Google intenta ofrecer a sus usuarios solo las páginas más relevantes y técnicamente sanas. Si una página contiene demasiados errores o no cumple las directrices de calidad, el buscador puede decidir no indexarla. Suele ser una señal de que hacen falta optimizaciones más profundas. Si buscas apoyo profesional para estructurar tu web, una visita a SEO Websites puede aportarte ideas valiosas para sortear estos obstáculos.
- Una configuración errónea del sitemap que impide que se detecte el contenido nuevo.
- El uso de etiquetas canónicas que apuntan a versiones de URL equivocadas.
- Errores del servidor que bloquean el acceso de los buscadores de forma temporal o permanente.
- Páginas protegidas tras una pantalla de inicio de sesión y, por tanto, inaccesibles para los rastreadores.
Revisa tu archivo robots.txt en busca de bloqueos
El archivo robots.txt suele ser lo primero que miran los buscadores cuando visitan tu web. Este pequeño archivo de texto hace de guardia de tráfico y decide qué carpetas y páginas son accesibles para rastreadores como Googlebot. Si contiene instrucciones incorrectas, aparecen de inmediato problemas de indexación persistentes que pueden dañar gravemente tu visibilidad orgánica. Es esencial entender que una regla «Disallow» errónea puede volver invisibles secciones enteras de tu sitio para los buscadores, aunque el resto de tu SEO técnico esté perfecto.
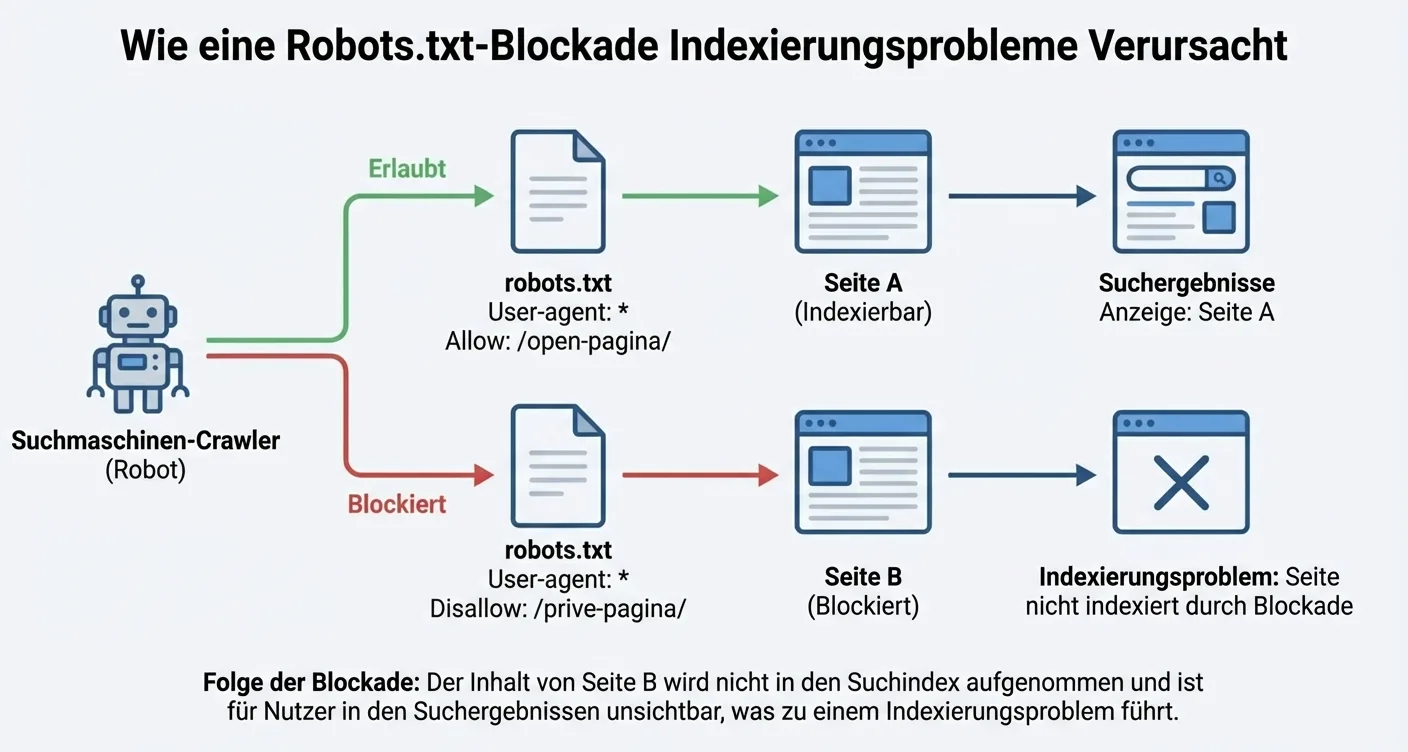
¿Cómo detectar errores críticos en el robots.txt?
La causa más habitual de los problemas de indexación por el robots.txt es bloquear sin querer toda la web tras una migración o durante una fase de pruebas. Suele pasar por dejar la regla «Disallow: /», que en la práctica le dice a cualquier bot que todo el sitio es terreno prohibido. Por eso es muy importante revisar con regularidad la sintaxis del archivo con herramientas como Google Search Console. Allí puedes comprobar si determinadas URL que sí quieres ver en los resultados de búsqueda no están siendo frenadas por error por una regla restrictiva en la raíz de tu servidor.
📋 Optimiza tu flujo de trabajo
Además de revisar el código a mano, también puedes recurrir a herramientas inteligentes como el Generador de productos con IA para optimizar tu flujo de trabajo.
Por qué es importante
«Un pequeño error tipográfico en tu robots.txt puede marcar la diferencia entre una de las primeras posiciones en Google y la invisibilidad total en los resultados de búsqueda.»
El impacto de la eficiencia de rastreo en tu posicionamiento
Cuando a los buscadores les cuesta recorrer tu sitio, desperdician el llamado presupuesto de rastreo (crawl budget) en páginas irrelevantes o se quedan atascados en bloqueos. Esto agrava los problemas técnicos de indexación que ya existen, porque el contenido nuevo no se detecta ni se procesa a tiempo en el índice. Si usas el archivo robots.txt de forma estratégica, llevas a los rastreadores directamente a las partes más relevantes de tu web. Es una herramienta potente para fijar prioridades, siempre que sepas exactamente qué carpetas excluir y cuáles abrir a los rastreadores.
⚡ Recuerda esto
No olvides que solucionar los problemas de indexación configurando el robots.txt es un proceso minucioso en el que cada regla cuenta para tu éxito.
Para mantener tu web en buena forma y controlarla mejor, puedes seguir estos pasos:
📝 Comprobar la ubicación del sitemap
Comprueba que la ubicación del sitemap aparece correctamente al final del archivo.
📝 Verificar los recursos
Verifica que recursos importantes como CSS y JavaScript no estén bloqueados.
📝 Probar con Search Console
Usa el informe de robots.txt de Search Console para comprobar que Google puede obtener tu archivo, y la herramienta de inspección de URLs para probar una URL concreta.
📝 Definir el user-agent
Asegúrate de que el user-agent esté bien definido para cada bot concreto.
Si revisas estos elementos periódicamente, evitarás que problemas de indexación inesperados frenen tu crecimiento.
Cómo detectar un uso incorrecto de la etiqueta noindex
⚡ Paso crucial
Localizar una etiqueta noindex mal colocada es un paso crucial para resolver problemas de indexación persistentes dentro de tu estrategia digital. Cuando una página lleva esta instrucción por error, les estás diciendo explícitamente a los buscadores que ignoren por completo su contenido en los resultados, algo que puede ser desastroso para tu visibilidad orgánica. Este fallo suele colarse en el paso de un entorno de pruebas a la web en producción, cuando los desarrolladores olvidan quitar los bloqueos pensados para evitar contenido duplicado durante la fase de desarrollo. Identificar estas barreras ocultas exige un enfoque sistemático en el que se analizan a fondo tanto el código fuente como las cabeceras HTTP, para garantizar que las páginas valiosas vuelvan a ser visibles para el público.
Revisa siempre primero el código fuente de tus páginas de destino más importantes en busca de la etiqueta meta robots con el valor «noindex».
Métodos técnicos de detección
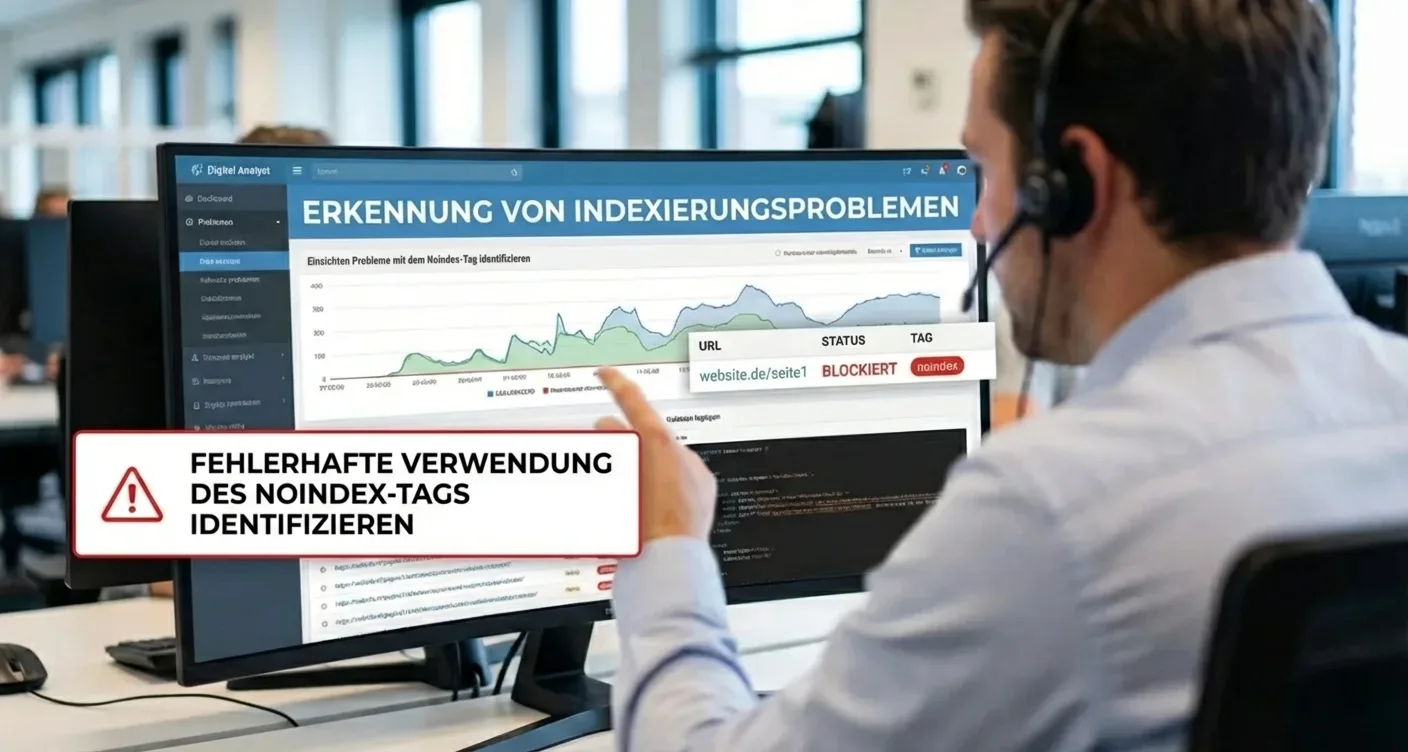
Además de las metaetiquetas habituales en la sección HTML, los problemas de indexación por ajustes noindex también pueden esconderse más a fondo en la configuración del servidor, a través de la cabecera HTTP X-Robots-Tag. Es un método menos visible que se suele usar para archivos PDF o imágenes, pero que, por un error de configuración en el archivo .htaccess, puede aplicarse sin querer a directorios enteros. Para comprobarlo de forma eficaz, revisa las cabeceras HTTP de la página, por ejemplo con la herramienta de inspección de URLs de Google Search Console. El Optimizador SERP te muestra además cómo aparecen tus páginas en los resultados de búsqueda. Es esencial entender que una instrucción noindex siempre tiene prioridad sobre la inclusión en el sitemap, de modo que tus páginas siguen siendo invisibles pese a tus esfuerzos por enviarlas.
Lección importante
«Una sola línea de código puede marcar la diferencia entre una de las primeras posiciones y la invisibilidad total en los buscadores.»
Las auditorías periódicas de tu web son necesarias para evitar que surjan nuevos problemas de indexación tras cada actualización de software o cambio de contenido.
Para hacerte una idea completa del estado de tu web, puedes seguir estos pasos durante la inspección:
-
📝 Inspeccionar el código fuente
Usa la función «Inspeccionar» de tu navegador para buscar «noindex» en la sección head.
-
📝 Consultar Google Search Console
Consulta los informes de Google Search Console para ver qué páginas se han excluido por la etiqueta noindex.
-
📝 Hacer un rastreo completo
Haz un rastreo completo con software SEO para localizar a gran escala los problemas de indexación por metaetiquetas erróneas.
-
📝 Revisar el robots.txt
Revisa tu archivo robots.txt para ver si hay instrucciones contradictorias que bloqueen el acceso.
Si ves que páginas importantes no aparecen en los resultados de búsqueda, conviene hacer un análisis a fondo de la estructura técnica de tu sitio. Resolver los problemas de indexación empieza por entender la jerarquía de las instrucciones para buscadores, en la que la etiqueta noindex suele ser el bloqueo más potente y hay que retirarla a mano.
Problemas de indexación por una mala estructura de enlaces internos
⚡ Principio fundamental
Una arquitectura web bien pensada es la base del posicionamiento en buscadores. Cuando la estructura de enlaces internos es caótica, los problemas de indexación son inevitables. Googlebot y otros rastreadores usan los enlaces para ir de una página a otra. Si las páginas importantes están enterradas en lo más profundo de la jerarquía o no reciben ningún enlace desde otras páginas, sencillamente no se encuentran. El resultado es contenido valioso que sigue siendo invisible para los posibles visitantes, solo porque faltan las señales técnicas que guían al buscador hasta el destino correcto dentro de tu dominio.
Sin una estructura lógica, malgastas un presupuesto de rastreo muy valioso en páginas irrelevantes mientras se ignoran tus páginas clave.
El impacto de las páginas huérfanas y las jerarquías profundas
Las páginas huérfanas son URL a las que no enlaza ninguna otra página de la web. Para los buscadores son prácticamente imposibles de encontrar, lo que lleva directamente a problemas de indexación persistentes en webs nuevas. Además, la profundidad de clic desempeña un papel crucial: las páginas que están a más de tres o cuatro clics de la página de inicio suelen recibir menos prioridad. Una estructura plana reparte mejor la autoridad por todo el sitio, de modo que cada página tiene una oportunidad justa de aparecer en los resultados de búsqueda de Google.
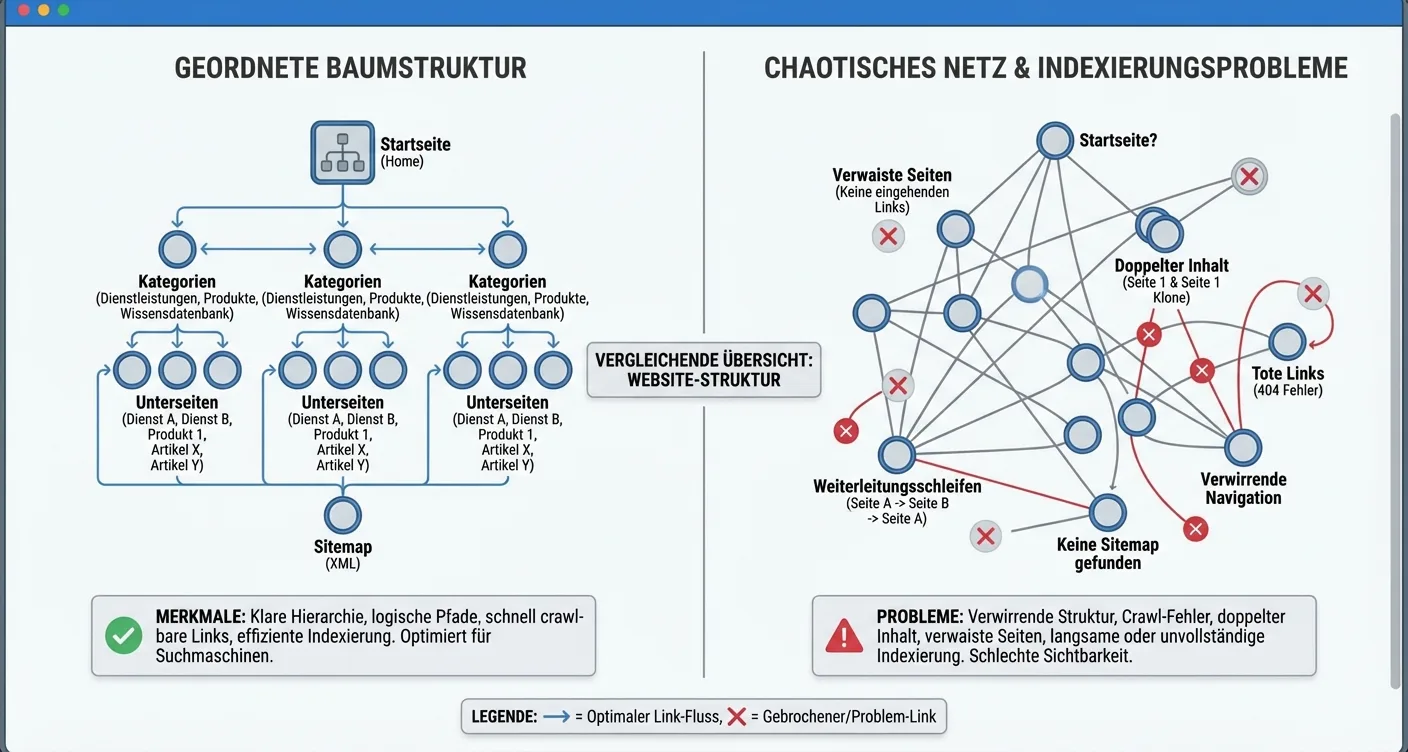
Es esencial hacer auditorías técnicas con regularidad para identificar estas barreras ocultas y corregirlas de inmediato.
Metáfora
«Una web sin enlaces internos es como una biblioteca con los libros tapiados tras un muro: la información está ahí, pero nadie puede llegar a ella.»
Para abordar los problemas de indexación de forma eficaz, puedes optimizar estos elementos de tu estructura de navegación:
-
📝 Una estructura de menú clara
Usa una estructura de menú clara que dé acceso directo a las categorías más importantes.
-
📝 Implementar migas de pan
Implementa migas de pan (breadcrumbs) para ayudar tanto a los usuarios como a los rastreadores a entender el contexto de una página.
-
📝 Enlaces de texto relevantes
Incluye en tus artículos de blog enlaces de texto relevantes hacia servicios o productos relacionados.
-
📝 Usar un sitemap XML
Utiliza un sitemap XML, pero no confíes solo en él para lograr la indexación completa.
Mejorar el valor de los enlaces internos no solo ayuda a resolver problemas de indexación persistentes, sino que también refuerza la relevancia de tus palabras clave más importantes. Si enlazas de forma estratégica con los textos ancla adecuados, envías una señal clara sobre el tema de la página de destino. Solucionar los problemas de indexación con enlaces internos exige un enfoque constante en el que cada página nueva se integra de inmediato en la red de contenido existente. No olvides que una identidad de marca sólida también contribuye a la autoridad de tu dominio.
📋 Refuerza tu identidad de marca
Para ello puedes usar un generador de branding que refuerce tu imagen profesional.
Una estructura de enlaces sana es el camino más rápido hacia una web totalmente indexada que rinde al máximo en los buscadores.
El impacto del contenido duplicado en tu indexación
⚠️ Atención
Cuando buscadores como Google se encuentran con textos idénticos o muy parecidos en distintas URL, el algoritmo se confunde. El buscador tiene que decidir qué versión de la página es la más relevante para el usuario, lo que a menudo provoca importantes problemas de indexación. En lugar de que todas tus páginas posicionen bien, puede que se muestre la página equivocada o que la autoridad de tu web se reparta entre varias URL. Este fenómeno se conoce como «canibalización de palabras clave»: tus propias páginas compiten entre sí por la misma posición en los resultados de búsqueda.
El contenido duplicado obliga a los buscadores a tomar decisiones que preferirías controlar tú mismo para evitar problemas de indexación persistentes.
Cómo el contenido duplicado desperdicia tu presupuesto de rastreo
Los buscadores tienen un presupuesto de rastreo limitado para cada web, lo que significa que solo escanean un número determinado de páginas en cada visita. Si tu sitio está lleno de contenido duplicado, el rastreador pierde un tiempo valioso procesando información que ya conoce, y las páginas nuevas o actualizadas sencillamente pasan desapercibidas. Este proceso agrava considerablemente los problemas de indexación en webs grandes que ya existen.
📋 La estructura es esencial
Por eso es esencial mantener una estructura clara, por ejemplo con el Productmap Architect, que te ayuda a organizar rutas de contenido únicas.
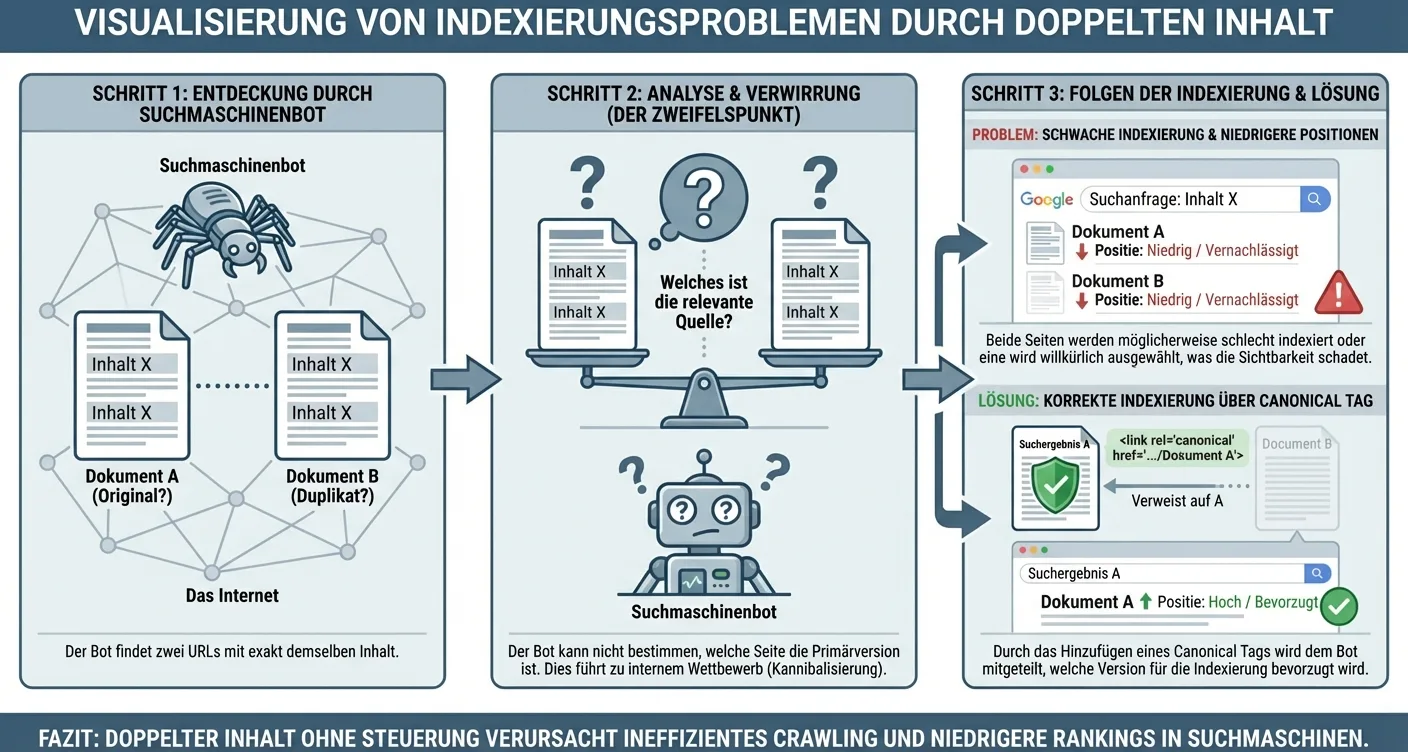
Sin esta orientación, los buscadores se quedan atrapados en un bucle infinito de repeticiones, lo que perjudica la visibilidad general de tu dominio.
Consideración importante
«El contenido duplicado no es necesariamente una penalización, pero sí un enemigo de la eficiencia que altera gravemente la comunicación entre tu servidor y el buscador.»
Estrategias para minimizar el contenido duplicado
Para limitar el impacto negativo en tu visibilidad, tienes que actuar de forma proactiva al gestionar los textos de tu web. Las etiquetas canónicas son uno de los métodos más eficaces, porque con ellas le indicas explícitamente al buscador qué versión de una página debe considerarse la original. Así, solucionar los problemas de indexación con URL canónicas pasa a formar parte de tu estrategia de SEO técnico. Además, conviene hacer auditorías periódicas para localizar y eliminar duplicados involuntarios, como versiones para imprimir de las páginas o identificadores de sesión en las URL.
-
📝 Usar redirecciones 301
Usa redirecciones 301 para llevar las páginas antiguas a las versiones nuevas y únicas.
-
📝 Limitar los parámetros de URL
Limita las variaciones de URL con etiquetas canónicas y enlaces internos coherentes. La herramienta de parámetros de URL de Search Console dejó de existir en 2022.
-
📝 Metadatos únicos
Asegúrate de que cada página tenga su propia metadescripción y su propio título.
-
📝 Mantener fuera del índice los resultados de búsqueda internos
Añade una etiqueta noindex a los resultados de búsqueda internos para mantenerlos fuera del índice. El robots.txt solo controla el rastreo.
Si sigues estos pasos con constancia, reduces el riesgo de problemas de indexación complejos y te aseguras de que los algoritmos reconozcan plenamente el valor único de tu contenido.
Errores técnicos: presupuesto de rastreo y respuesta del servidor
⚡ La columna vertebral de la visibilidad
Cuando hablamos de la salud técnica de una web, la respuesta del servidor y el presupuesto de rastreo son la columna vertebral de una buena visibilidad orgánica. Googlebot no tiene tiempo infinito para explorar cada rincón de tu dominio: hay un límite estricto de páginas que un rastreador visita en un periodo determinado. Si tu servidor responde con lentitud o se cargan demasiados scripts innecesarios, el buscador pierde un tiempo valioso. Esto conduce inevitablemente a problemas de indexación persistentes, en los que el contenido nuevo o actualizado sencillamente no llega a los resultados de búsqueda porque el bot ya se ha ido antes de alcanzar las páginas relevantes.
Un servidor lento suele ser la barrera invisible que impide que los buscadores descubran a tiempo tus páginas más valiosas.
Optimización del presupuesto de rastreo
Gestionar el presupuesto de rastreo exige un enfoque estratégico en el que das prioridad a las páginas que de verdad aportan valor al usuario. Muchas webs sufren problemas de indexación por contenido duplicado o por combinaciones infinitas de filtros en las tiendas online que atrapan al rastreador en un laberinto. Con un archivo robots.txt puedes indicar a los buscadores que se salten carpetas irrelevantes. Así queda más margen para las páginas principales. Es esencial entender que solucionar los problemas técnicos de indexación optimizando el servidor influye directamente en la frecuencia y la profundidad con que Google rastrea tu web.
Además de la estructura, la respuesta del servidor (TTFB) desempeña un papel crucial en este proceso. Cuando un servidor tarda demasiado en enviar el primer byte de datos, el buscador lo interpreta como una señal de inestabilidad o de bajo rendimiento. A menudo, el resultado es una menor frecuencia de rastreo. Para evitar estos problemas técnicos de indexación, conviene invertir en un alojamiento de calidad y en mecanismos de caché. Un servidor rápido permite que el bot procese más páginas en el mismo tiempo, lo que aumenta considerablemente las posibilidades de que todo tu sitio quede indexado.
Revisa con regularidad tus archivos de registro (logs) para ver dónde se atascan los rastreadores o sufren retrasos innecesarios durante su visita a tu dominio.
Errores del servidor y códigos de estado
Los códigos de estado como los errores 5xx son nefastos para tu reputación ante los buscadores. Cuando Google se encuentra repetidamente con errores del servidor, el rastreador visita el sitio con menos frecuencia para no sobrecargarlo más. Esto crea un círculo vicioso de problemas de indexación en webs grandes.
📋 Vigila Search Console
Por eso es muy importante vigilar de cerca Search Console por si aparecen avisos sobre la accesibilidad del servidor. Si quieres información más detallada para mejorar tu presencia online, consulta nuestro blog.
ℹ️ Puntos críticos
- Reduce al mínimo el número de redirecciones (301/302) para que la cadena de rastreo sea corta.
Configuración del sitemap e inspección manual de URL
⚡ Un mapa de ruta para los buscadores
Un sitemap XML bien configurado funciona como un mapa de ruta para los buscadores, que así pueden recorrer la estructura de tu web con más eficiencia. Cuando ese mapa contiene errores o información desactualizada, suelen aparecer problemas de indexación persistentes que lastran la visibilidad de tus páginas más importantes. Es esencial que el sitemap contenga solo URL canónicas con código de estado 200, para que los rastreadores no pierdan tiempo en redirecciones o páginas inexistentes. Si das prioridad al contenido de calidad en la configuración de tu sitemap, envías a Google una señal clara sobre qué secciones de tu dominio aportan más valor al usuario final.
Enviar URL manualmente a través de Google Search Console es un método muy eficaz para acelerar la solución de problemas de indexación con sitemaps.
Inspección manual de URL y validación
La herramienta de inspección de URL te muestra en detalle cómo ve Google una página concreta y si hay barreras técnicas que impiden incluirla en el índice. En la práctica, muchos administradores olvidan solicitar una nueva indexación tras un cambio técnico, de modo que los avisos de error antiguos siguen ahí más tiempo del necesario. Con la función de prueba en directo puedes verificar al momento si el código actual cumple los requisitos del buscador. Este proceso es crucial para identificar problemas de indexación por errores técnicos en el sitemap, ya que así cierras la brecha entre tu base de datos y los resultados de búsqueda.
Para afinar tu estrategia, puedes seguir estos pasos y lograr una configuración óptima:
-
📝 Quitar las páginas noindex
Elimina del sitemap XML las páginas con etiqueta «noindex» para no confundir a los rastreadores.
-
📝 Agrupar las URL
Reparte las URL en varios sitemaps si tu web tiene más de cincuenta mil páginas.
-
📝 Revisar el informe Páginas
Revisa con regularidad el informe Páginas en busca de avisos de problemas de indexación concretos.
-
📝 Indicar el sitemap en el robots.txt
Asegúrate de que la ubicación del sitemap figure correctamente en el archivo robots.txt para una máxima visibilidad.
Supervisión constante
Supervisar de forma constante el estado del sitemap es la única manera de prevenir los problemas de indexación estructurales a largo plazo.
Si ves que algunas páginas no se incluyen pese a tener un sitemap correcto, la inspección manual es la solución. Ahí puedes ver si la página se ha rastreado pero todavía no se ha indexado, lo que a menudo indica falta de autoridad o de contenido único. Si combinas esta información con una estructura de sitemap bien cuidada, reduces considerablemente el riesgo de problemas de indexación en webs nuevas.
Plan paso a paso para solucionar tus problemas de indexación para siempre
✨ Soluciona tus problemas de indexación de forma definitiva
Abordar los problemas de indexación de forma estructural exige un análisis a fondo de los cimientos técnicos de tu web. Cuando Google ignora ciertas páginas, la causa suele ser una estructura de enlaces internos deficiente o una configuración errónea del archivo robots.txt. Es esencial comprobar primero que esas URL no se hayan excluido por error con una etiqueta noindex. Si eliminas cada barrera de forma sistemática, te aseguras de que los buscadores recorran tu contenido sin esfuerzo y lo incluyan correctamente en su base de datos para las búsquedas relevantes de los usuarios.
Corregir los problemas de indexación de forma eficaz empieza siempre por una auditoría completa de los datos de Google Search Console para detectar patrones en los avisos de error.
Optimización técnica y sitemaps
Un paso crucial en este proceso es enviar un sitemap XML actualizado. Este archivo funciona como un mapa de ruta para los rastreadores y ayuda a priorizar las páginas importantes. Comprueba también que tu servidor responda con agilidad: unos tiempos de carga lentos pueden hacer que los rastreadores abandonen antes de tiempo, lo que indirectamente provoca problemas de indexación persistentes en webs nuevas. Asegúrate de que todas las etiquetas canónicas estén bien configuradas para evitar el contenido duplicado, ya que la confusión sobre la fuente original suele acabar con páginas excluidas de los resultados de búsqueda.
Sigue estos pasos para obtener un resultado óptimo:
-
📝 Verificar el estado de las URL
Verifica el estado de tus URL en Google Search Console.
-
📝 Revisar el sitemap
Comprueba la accesibilidad de tus páginas más importantes a través del sitemap.
-
📝 Eliminar redirecciones innecesarias
Elimina las redirecciones innecesarias que sobrecargan el presupuesto de rastreo.
-
📝 Optimizar el valor de los enlaces internos
Optimiza el valor de los enlaces internos hacia las páginas más profundas.
Una regla de oro importante
«Una web sana es aquella en la que cada página valiosa está como máximo a tres clics, tanto para el usuario como para el bot del buscador.»
Además, es buena idea inspeccionar a mano con regularidad las URL concretas que se quedan atrás. Usa la «herramienta de inspección de URL» para solicitar la indexación justo después de hacer cambios. Solucionar los problemas de indexación con SEO técnico es un proceso continuo que hay que vigilar de cerca para garantizar el éxito a largo plazo. No olvides que el contenido de calidad sigue siendo la base: incluso con la mejor técnica, Google se negará a indexar páginas que no aporten valor añadido. Si conviertes el análisis de problemas de indexación complejos en una parte fija de tu mantenimiento, mantendrás una visibilidad online sólida.
ℹ️ Consejo importante
Estate siempre atento a las caídas repentinas del número de páginas indexadas en tu panel.
⚡ Idea central
Detectar a tiempo los problemas de indexación es esencial para tu visibilidad online.
📋 La base de tu SEO
Si abordas de forma sistemática barreras técnicas como una configuración errónea del robots.txt o una estructura de enlaces internos deficiente, sientas una base sólida para tu estrategia SEO. Por eso, revisa con regularidad los datos de Search Console para detectar los bloqueos rápidamente y resolverlos de inmediato.
¿Listo para solucionar tus problemas de indexación?
En resumen, resolver problemas de indexación persistentes exige una mirada atenta tanto a la configuración técnica como a la calidad general de tu contenido. Ya se trate de eliminar etiquetas noindex, optimizar tu sitemap o mejorar la velocidad de carga, cada ajuste contribuye a una mejor visibilidad en Google.
Empieza hoy mismo con una auditoría →Consigue que tus páginas valiosas obtengan las posiciones orgánicas que merecen.
❓ ¿Qué son exactamente los problemas de indexación?
Los problemas de indexación se producen cuando buscadores como Google no consiguen incluir páginas de tu web en su base de datos. Como resultado, los usuarios no pueden encontrar tu contenido, lo que repercute de forma directa y negativa en tu tráfico orgánico.
❓ ¿Cómo puedo comprobar si mi web tiene problemas de indexación?
Puedes comprobarlo fácilmente en Google Search Console, en el informe «Páginas». Si ves que URL importantes aparecen como «No indexadas», es muy probable que tengas problemas de indexación concretos que debes resolver.
❓ ¿Por qué un archivo robots.txt bloquea a veces la indexación?
Un archivo robots.txt contiene instrucciones para los buscadores sobre qué partes del sitio no pueden visitar. Si por error se ha configurado una regla «Disallow» para carpetas importantes, Google no puede rastrear esas páginas, por lo que no suelen aparecer en los resultados o aparecen sin descripción. El robots.txt controla el rastreo, no la indexación: para mantener una página fuera del índice, usa una etiqueta noindex en una página que Google pueda rastrear.
❓ ¿Cuándo suelen aparecer las páginas nuevas en los resultados de búsqueda?
Este proceso puede ir de unas horas a varias semanas, según la autoridad de tu web. Si envías un sitemap XML y solicitas la indexación manualmente, puedes acelerar el proceso y evitar retrasos.
Sobre el autor: Dries Nijs es Organic Web Specialist en MadeByDries. Desde los años 90 crea sitios web, tiendas online y aplicaciones web con WordPress y React, con SEO y GEO integrados.
Artículos relacionados
- Auditoría de página web: por qué no posicionas y qué hacer
Descubre con una auditoría de página web por qué tu página no posiciona y qué soluciones rinden más. Con checklist y prioridades para actuar rápido.
- ¿Contratar una auditoría SEO? Subir en Google empieza aquí
¿Quieres más tráfico orgánico? Encarga una auditoría SEO profesional y descubre todo lo que puedes mejorar. ¡Empieza hoy a crecer en Google!
- Optimizar Core Web Vitals: guía para tu contenido
Descubre cómo optimizar Core Web Vitals para que tu contenido posicione mejor en Google. Aprende todo sobre LCP, INP y CLS y mejora tu web hoy mismo.
- Soluciones al solapamiento de contenido: optimiza tu SEO
Descubre soluciones eficaces al solapamiento de contenido para frenar la canibalización. Mejora tus posiciones con nuestra guía práctica.
- Páginas huérfanas y grafo de enlaces internos: mejora tu SEO
Descubre cómo un grafo de enlaces internos saca a la luz las páginas huérfanas. Mejora tu visibilidad y repara los enlaces rotos. ¡Lee nuestra guía!